Conceptos básicos de análisis de datos y Machine Learning: guía para empezar desde cero
Qué es un dataset, una variable, un modelo, el overfitting, la validación cruzada o la diferencia entre interpretabilidad y explicabilidad. Una guía clara y en español con los conceptos básicos de análisis de datos y Machine Learning, con ejemplos en Python.
fundamentos
análisis de datos
machine learning
glosario
Autor/a
Robinson Miranda
Fecha de publicación
8 de octubre de 2026
Fecha de última modificación
8 de octubre de 2026
Palabras clave
qué es machine learning, conceptos básicos de machine learning, análisis de datos para principiantes, glosario de machine learning en español, aprendizaje supervisado, overfitting, validación cruzada, interpretabilidad vs explicabilidad, IA explicable, python, scikit-learn
Cuando empiezas en datos te encuentras con un muro de palabras: feature, target, overfitting, train/test, validación cruzada. Cada tutorial las usa como si ya las conocieras.
Este post es el que me habría gustado leer al principio (si quieres saber por qué empecé este blog, te lo cuento aquí). Es un mapa de los conceptos fundamentales, explicados en lenguaje simple y en el orden en que los vas a necesitar. Puedes leerlo de corrido o usarlo como glosario y volver cuando un término te frene.
TipCómo leer este post
Cada concepto tiene tres partes: qué es, un ejemplo y por qué importa. Al final hay un ejemplo completo en Python que junta casi todo. Puedes ejecutarlo gratis en Google Colab sin instalar nada.
Parte 1. Los datos
¿Qué es un dataset?
Qué es: un conjunto de datos organizado, casi siempre en forma de tabla. Cada fila es un caso (una persona, una venta, una transacción) y cada columna es una característica de ese caso.
Ejemplo: una tabla de clientes de un banco, donde cada fila es un cliente y las columnas son edad, ingresos, ciudad y si pagó o no su crédito.
Por qué importa: casi todo en análisis de datos y Machine Learning empieza con una tabla así. Entender qué representa cada fila es la primera pregunta que debes hacerte.
Observación y variable
Observación (fila, registro, muestra): cada caso individual del dataset.
Variable (columna, atributo): cada característica que mides de esos casos.
Si tienes 1.000 clientes y 8 columnas, tienes 1.000 observaciones y 8 variables.
Tipos de variables
Qué es: no todas las columnas son iguales, y el tipo decide qué puedes hacer con ellas.
Tipo
Qué representa
Ejemplo
Numérica continua
Una medida que puede tomar cualquier valor
Ingresos, temperatura, peso
Numérica discreta
Un conteo
Número de hijos, compras al mes
Categórica nominal
Grupos sin orden
Ciudad, color, tipo de producto
Categórica ordinal
Grupos con un orden
Nivel educativo, talla S/M/L
Fecha y hora
Un momento en el tiempo
Fecha de compra
Texto
Lenguaje libre
Comentarios de clientes
Por qué importa: no puedes sacar el promedio de una ciudad, y un modelo no entiende la palabra “Medellín” a menos que la conviertas en números. Saber el tipo de cada variable evita errores silenciosos.
Datos estructurados y no estructurados
Estructurados: datos en tablas con columnas definidas (una hoja de cálculo, una base de datos SQL).
No estructurados: texto, imágenes, audio, video. No vienen en filas y columnas.
Este blog empieza por los estructurados, que es donde vive la mayoría del trabajo en empresas.
Parte 2. Análisis de datos
¿Qué es el análisis de datos?
Qué es: el proceso de inspeccionar, limpiar, transformar y resumir datos para responder preguntas y tomar decisiones.
Ejemplo: “¿En qué meses vendemos más?” o “¿Qué clientes tienen más probabilidad de dejar de comprar?”.
Por qué importa: antes de cualquier modelo de Machine Learning hay un análisis. Muchas preguntas de negocio se responden con un buen análisis, sin necesidad de un modelo.
Análisis exploratorio de datos (EDA)
Qué es: el primer contacto serio con un dataset. Revisas su tamaño, tipos de variables, valores faltantes, distribuciones y relaciones entre columnas.
Por qué importa: es donde descubres los problemas antes de que te exploten en la cara. Un modelo entrenado sobre datos que no entiendes es una caja negra encima de otra caja negra.
Estadística descriptiva
Son los números que resumen una variable:
Media (promedio): la suma de los valores dividida entre la cantidad. Sensible a valores extremos.
Mediana: el valor del medio cuando ordenas los datos. Más robusta ante extremos.
Moda: el valor que más se repite.
Desviación estándar: qué tan dispersos están los valores alrededor de la media.
Percentiles y cuartiles: el percentil 90 es el valor por debajo del cual está el 90% de los datos.
NotaMedia vs. mediana en la vida real
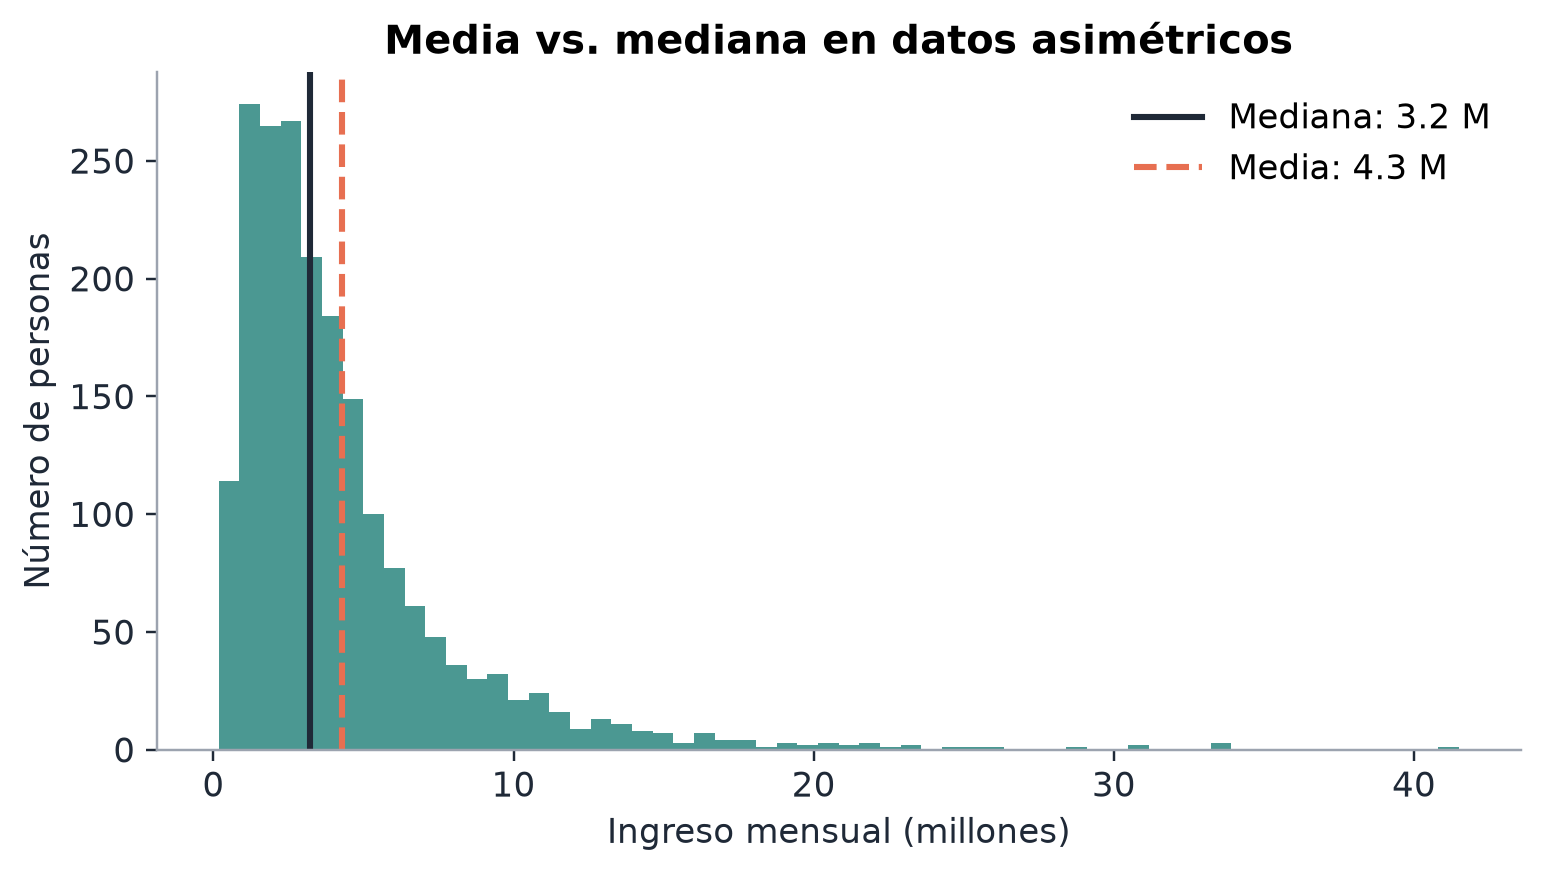
Si en una sala hay 9 personas que ganan 2 millones y entra alguien que gana 200 millones, la media se dispara a casi 22 millones. La mediana sigue en 2 millones. Por eso los ingresos casi siempre se reportan con la mediana.
Así se ve en una distribución real de ingresos, donde unos pocos valores muy altos jalan la media hacia la derecha:
Ver el código del gráfico
ingresos = rng.lognormal(mean=1.0, sigma=0.8, size=2000) *1.2# millonesfig, ax = plt.subplots(figsize=(8, 4))ax.hist(ingresos, bins=60, color=TEAL, alpha=0.75)ax.axvline(np.median(ingresos), color=DARK, lw=2, label=f"Mediana: {np.median(ingresos):.1f} M")ax.axvline(ingresos.mean(), color=CORAL, lw=2, ls="--", label=f"Media: {ingresos.mean():.1f} M")ax.set(xlabel="Ingreso mensual (millones)", ylabel="Número de personas", title="Media vs. mediana en datos asimétricos")ax.legend(frameon=False)plt.show()
En datos con cola larga, la media se aleja de la mayoría de los casos; la mediana no.
Distribución
Qué es: la forma en que se reparten los valores de una variable. Se ve con un histograma.
Por qué importa: te dice si los datos están concentrados, si tienen cola larga hacia un lado (asimetría) o si hay grupos separados. Muchas técnicas asumen ciertas formas de distribución.
Valores faltantes
Qué es: celdas vacías en tu tabla (NaN, null, None).
Por qué importa: la mayoría de modelos no aceptan valores faltantes. Además, por qué falta un dato a veces es información en sí misma. Puedes eliminarlos, rellenarlos (imputar) o marcarlos, pero la decisión depende del contexto. La guía de datos faltantes de pandas explica cómo detectarlos y tratarlos.
Outliers (valores atípicos)
Qué es: valores muy alejados del resto.
Por qué importa: a veces son errores (una edad de 250 años), a veces son lo más interesante del dataset (una transacción fraudulenta). Nunca los borres sin entender qué son.
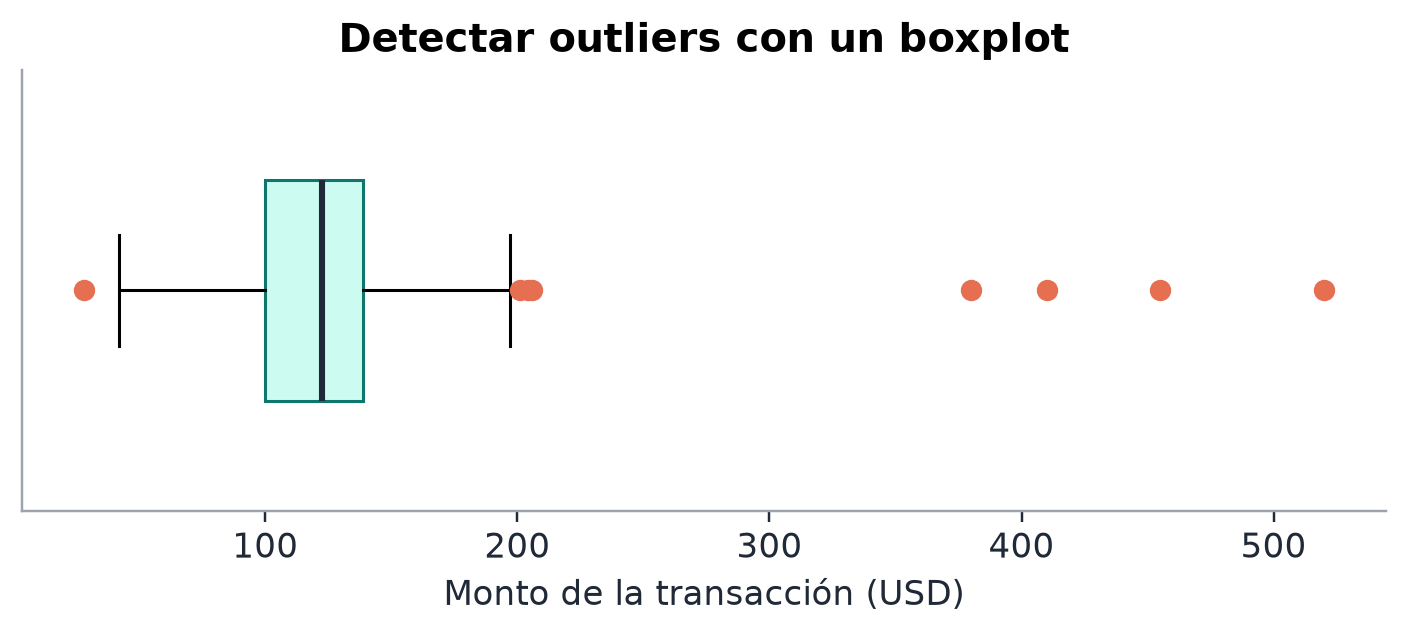
El diagrama de caja (boxplot) es la forma más rápida de verlos: los puntos sueltos fuera de los “bigotes” son candidatos a outlier.
Ver el código del gráfico
montos = np.concatenate([rng.normal(120, 30, 300), [380, 410, 455, 520]])fig, ax = plt.subplots(figsize=(8, 2.6))ax.boxplot(montos, vert=False, widths=0.5, patch_artist=True, boxprops=dict(facecolor="#ccfbf1", edgecolor=TEAL), medianprops=dict(color=DARK, lw=2), flierprops=dict(marker="o", markerfacecolor=CORAL, markeredgecolor=CORAL))ax.set(xlabel="Monto de la transacción (USD)", yticks=[], title="Detectar outliers con un boxplot")plt.show()
Los puntos fuera de los bigotes son posibles outliers. Hay que investigarlos antes de decidir qué hacer.
Correlación
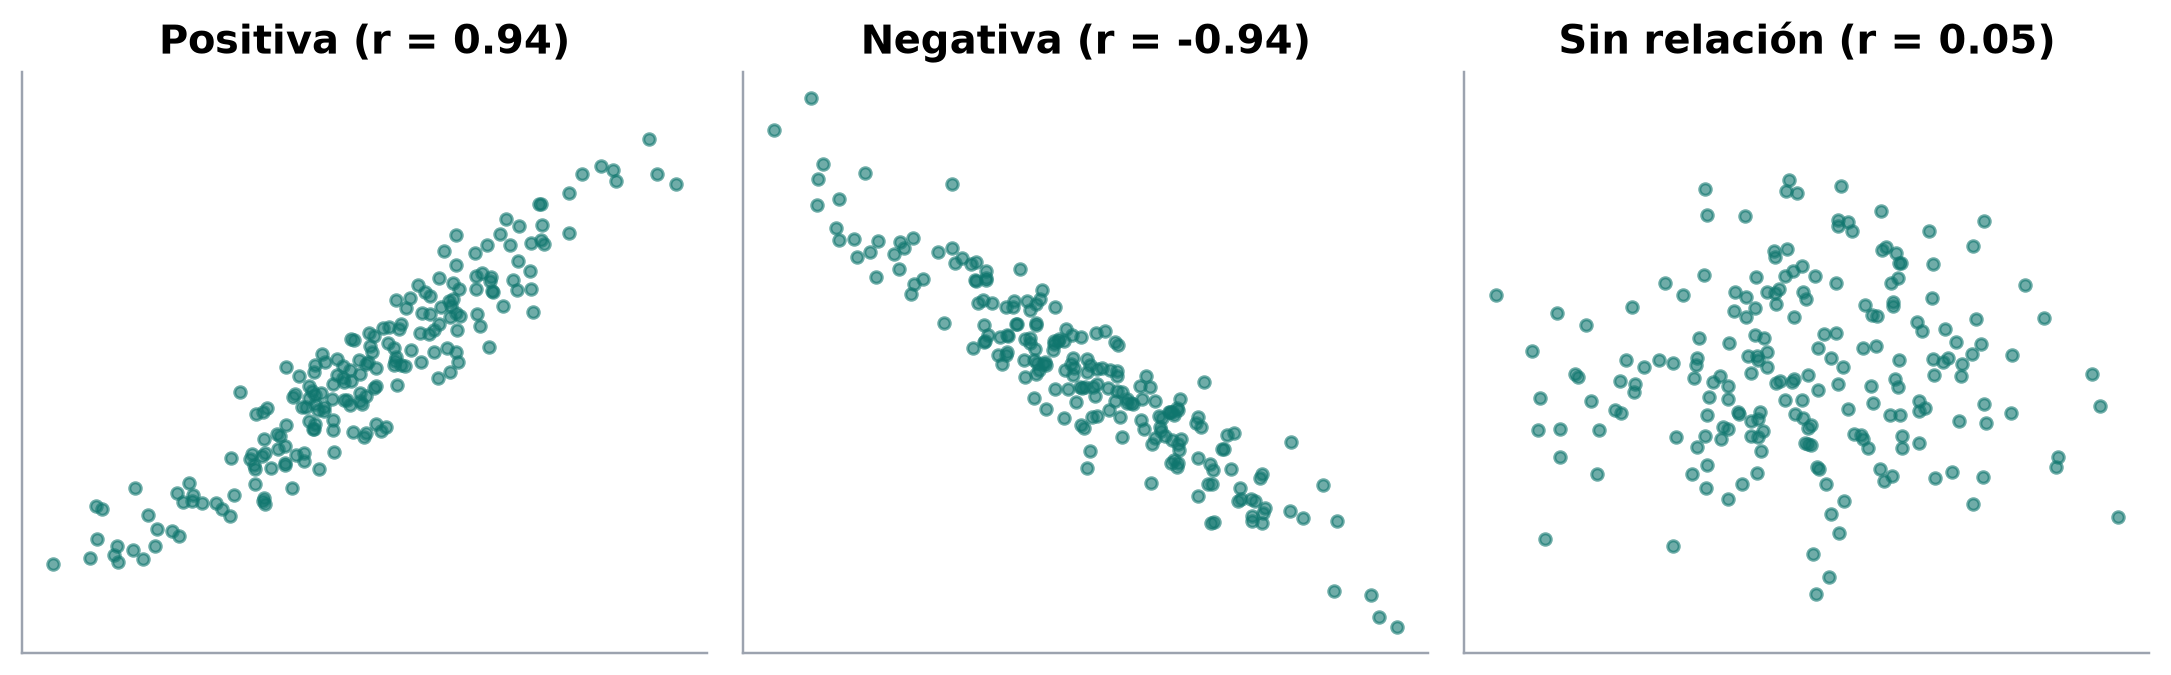
Qué es: una medida de qué tanto se mueven juntas dos variables numéricas. Va de -1 a 1.
Tres tipos de correlación entre dos variables numéricas.
AdvertenciaCorrelación no es causalidad
Las ventas de helado y los ahogamientos están correlacionados. No porque el helado cause ahogamientos, sino porque ambos suben en verano. Una correlación te da una pista, nunca una conclusión. A esta falacia se le conoce como cum hoc ergo propter hoc.
Limpieza de datos
Qué es: corregir o eliminar lo que está mal: duplicados, formatos inconsistentes (“Bogotá”, “bogota”, “BOGOTA”), tipos incorrectos, valores imposibles.
Por qué importa: la regla clásica es garbage in, garbage out. Si entra basura, sale basura, sin importar qué tan sofisticado sea el modelo.
Visualización de datos
Qué es: representar los datos en gráficos para entenderlos o comunicarlos. En Python las librerías más usadas son Matplotlib y seaborn. Los básicos:
Histograma: distribución de una variable numérica.
Diagrama de caja (boxplot): mediana, cuartiles y outliers.
Diagrama de dispersión (scatter): relación entre dos variables numéricas.
Gráfico de barras: comparar categorías.
Gráfico de líneas: evolución en el tiempo.
Parte 3. Machine Learning
¿Qué es Machine Learning?
Qué es: una rama de la inteligencia artificial donde, en lugar de programar reglas a mano, le das ejemplos a un algoritmo y él aprende los patrones por sí mismo.
Ejemplo: en vez de escribir reglas para detectar spam (“si dice gratis y tiene más de 3 enlaces…”), le das miles de correos marcados como spam o no spam y el modelo aprende a distinguirlos.
Por qué importa: permite resolver problemas donde las reglas son demasiadas o demasiado sutiles para escribirlas a mano.
Inteligencia artificial, Machine Learning y Deep Learning
Son círculos uno dentro del otro:
Inteligencia artificial (IA): el campo general de hacer que las máquinas realicen tareas que asociamos con inteligencia.
Machine Learning (ML): la parte de la IA que aprende a partir de datos.
Deep Learning: la parte del ML que usa redes neuronales con muchas capas. Es lo que está detrás del reconocimiento de imágenes y de los modelos de lenguaje como los chatbots.
Modelo
Qué es: el resultado de entrenar un algoritmo con datos. Es una función que recibe información de entrada y devuelve una predicción.
Ejemplo: un modelo que recibe metros cuadrados, barrio y número de habitaciones, y devuelve un precio estimado de la vivienda.
Features y target
Features (variables predictoras, X): la información que el modelo usa para predecir.
Target (variable objetivo, y): lo que quieres predecir.
En el ejemplo de la vivienda, los metros cuadrados y el barrio son features. El precio es el target.
Entrenamiento
Qué es: el proceso en el que el algoritmo ajusta sus parámetros internos mirando ejemplos, para que sus predicciones se parezcan lo más posible a las respuestas reales. En Python suele ser una sola línea: modelo.fit(X, y).
Tipos de aprendizaje
Tipo
Idea
Ejemplo
Supervisado
Aprende de ejemplos con la respuesta correcta
Predecir si un cliente pagará su crédito
No supervisado
Busca patrones sin respuestas previas
Agrupar clientes con hábitos parecidos
Por refuerzo
Aprende por prueba y error, con premios y castigos
Un agente que aprende a jugar un videojuego
Clasificación y regresión
Son los dos grandes tipos de problemas supervisados:
Clasificación: el target es una categoría. ¿Spam o no spam? ¿Fraude o no fraude?
Regresión: el target es un número. ¿Cuánto costará esta casa? ¿Cuántas unidades venderemos?
NotaOjo con el nombre
La regresión logística, a pesar del nombre, se usa para clasificación. Es una de esas trampas de vocabulario que confunden a todos al principio.
Clustering (agrupamiento)
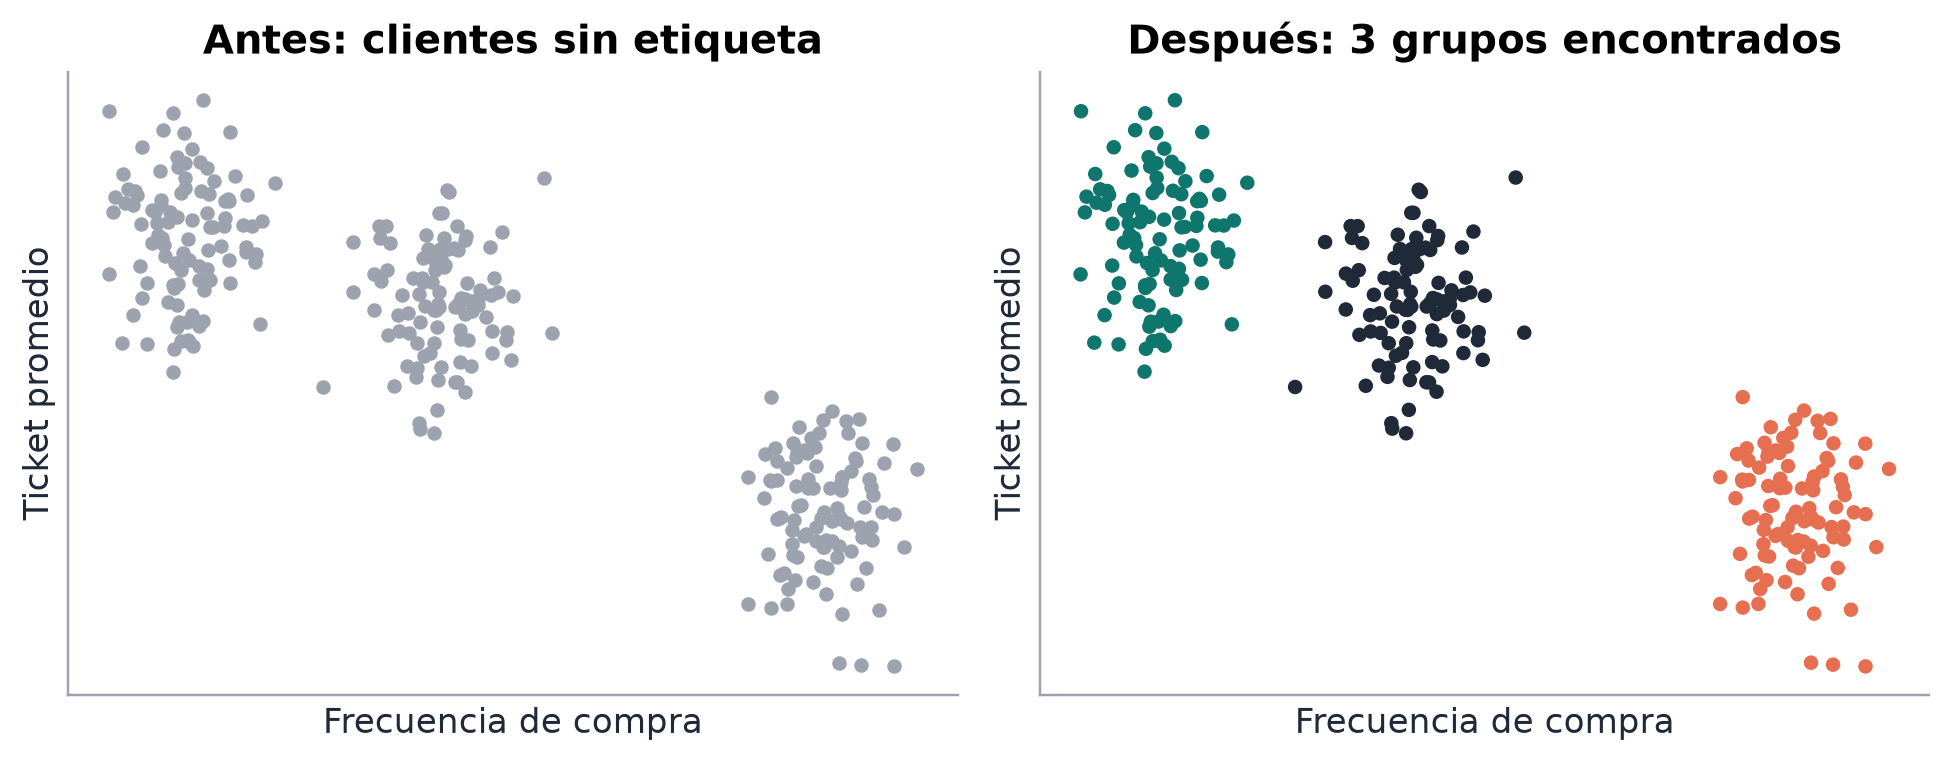
Qué es: una técnica no supervisada que agrupa observaciones parecidas sin saber de antemano a qué grupo pertenecen.
Ejemplo: segmentar clientes en grupos según su comportamiento de compra para diseñar campañas diferentes.
Ver el código del gráfico
from sklearn.datasets import make_blobsfrom sklearn.cluster import KMeansXc, _ = make_blobs(n_samples=300, centers=3, cluster_std=1.1, random_state=7)grupos = KMeans(n_clusters=3, n_init=10, random_state=7).fit_predict(Xc)fig, axes = plt.subplots(1, 2, figsize=(9, 3.6), sharex=True, sharey=True)axes[0].scatter(Xc[:, 0], Xc[:, 1], s=14, color=GRAY)axes[0].set_title("Antes: clientes sin etiqueta")axes[1].scatter(Xc[:, 0], Xc[:, 1], s=14, c=[[TEAL, CORAL, DARK][g] for g in grupos])axes[1].set_title("Después: 3 grupos encontrados")for ax in axes: ax.set(xlabel="Frecuencia de compra", ylabel="Ticket promedio", xticks=[], yticks=[])plt.tight_layout()plt.show()
K-Means encuentra grupos en los datos sin que nadie le diga cuáles son.
Algoritmos comunes para empezar
Regresión lineal: traza la línea que mejor se ajusta a los datos. Base de la regresión.
Regresión logística: estima la probabilidad de que algo pertenezca a una clase.
Árbol de decisión: una secuencia de preguntas sí/no. Fácil de interpretar.
Random Forest: muchos árboles que votan. Más preciso y estable que uno solo.
Gradient Boosting (XGBoost, LightGBM): árboles que se corrigen unos a otros. Muy fuertes en datos tabulares.
Redes neuronales: capas de operaciones que aprenden patrones complejos. La librería más popular para construirlas es PyTorch.
Parte 4. Evaluar un modelo
Train, validation y test
Qué es: dividir los datos en partes con funciones distintas.
Entrenamiento (train): el modelo aprende de aquí.
Validación: se usa para ajustar y comparar modelos.
Prueba (test): se usa una sola vez, al final, para medir el rendimiento real.
Por qué importa: si evalúas un modelo con los mismos datos con los que aprendió, es como darle a un estudiante el examen con las respuestas. Va a sacar 5, pero no aprendió nada.
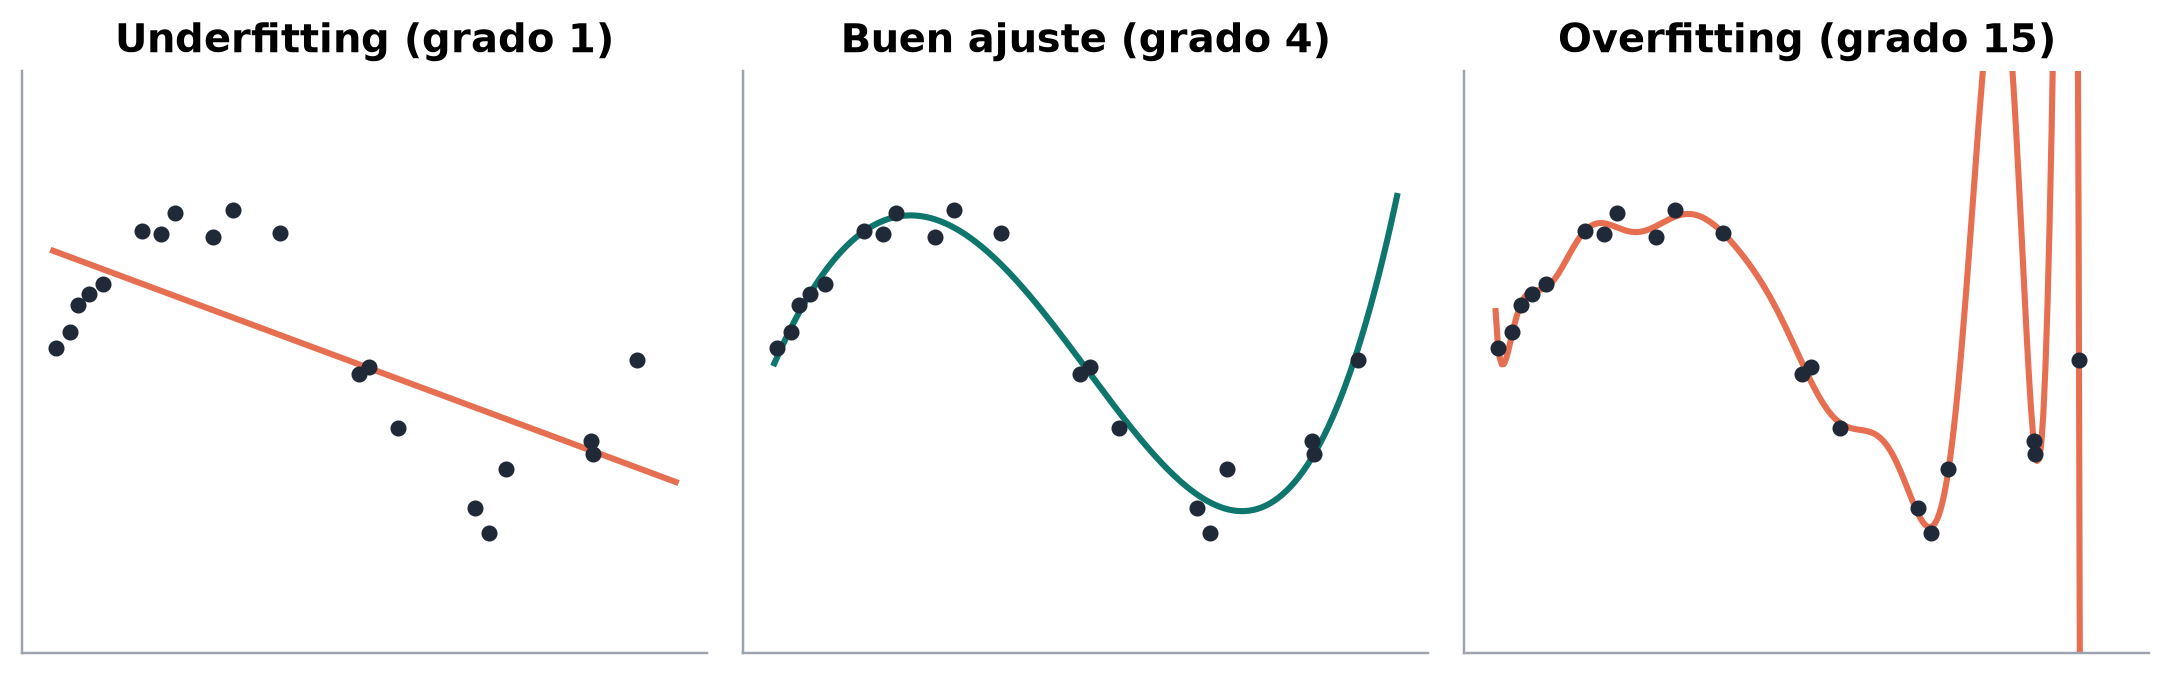
Overfitting y underfitting
Overfitting (sobreajuste): el modelo memorizó los datos de entrenamiento, incluido el ruido. Le va excelente en train y mal con datos nuevos.
Underfitting (subajuste): el modelo es demasiado simple y no capta ni siquiera los patrones básicos. Le va mal en todo.
El objetivo es el punto medio: un modelo que generaliza, es decir, que funciona bien con datos que nunca vio.
Mismo dataset, tres modelos: demasiado simple, adecuado y demasiado complejo.
Validación cruzada
Qué es: en lugar de una sola división train/test, divides los datos en k partes (por ejemplo 5), entrenas 5 veces dejando una parte distinta para evaluar cada vez, y promedias los resultados.
Por qué importa: te da una estimación más confiable y te muestra si el rendimiento es estable o si depende de la suerte de cómo partiste los datos. La documentación de scikit-learn sobre validación cruzada lo explica con diagramas muy claros.
Métricas de clasificación
Accuracy (exactitud): porcentaje de predicciones correctas. Engañosa cuando las clases están desbalanceadas.
Precision: de lo que el modelo marcó como positivo, cuánto era realmente positivo.
Recall (sensibilidad): de todos los positivos reales, cuántos encontró el modelo.
F1-score: balance entre precision y recall.
Matriz de confusión: tabla con aciertos y errores por clase.
ROC-AUC: qué tan bien separa el modelo las clases en todos los umbrales posibles. 0,5 es azar, 1 es perfecto.
AdvertenciaLa trampa del 99% de accuracy
Si solo el 1% de las transacciones son fraude, un modelo que siempre dice “no es fraude” tiene 99% de accuracy y no sirve para nada. Por eso en problemas desbalanceados se miran precision, recall y PR-AUC.
MAE (error absoluto medio): en promedio, por cuánto se equivoca el modelo. Fácil de explicar.
RMSE (raíz del error cuadrático medio): parecido, pero castiga más los errores grandes.
R² (coeficiente de determinación): qué proporción de la variación del target explica el modelo.
Sesgo y varianza
Sesgo: error por suposiciones demasiado simples (lleva al underfitting).
Varianza: error por ser demasiado sensible a los datos de entrenamiento (lleva al overfitting).
Mejorar uno suele empeorar el otro. A eso se le llama el trade-off sesgo-varianza.
Data leakage (fuga de datos)
Qué es: cuando información que no tendrías en el momento real de la predicción se cuela en el entrenamiento.
Ejemplo: predecir si un cliente abandonará el servicio usando una columna “fecha de cancelación”. El modelo parece perfecto, pero en la vida real esa columna no existe hasta que el cliente ya se fue.
Por qué importa: es una de las causas más comunes de modelos que brillan en el notebook y fracasan en producción. scikit-learn tiene una sección dedicada a errores comunes y buenas prácticas que vale la pena leer.
Parte 5. Preparar los datos para un modelo
Feature engineering
Qué es: crear o transformar variables para que el modelo aprenda mejor.
Ejemplo: a partir de “fecha de compra” crear “día de la semana” o “días desde la última compra”.
Encoding de variables categóricas
Qué es: convertir texto en números. La técnica más común es one-hot encoding: la columna “ciudad” se convierte en varias columnas (ciudad_Medellín, ciudad_Bogotá…) con 1 o 0.
Escalado y normalización
Qué es: poner las variables numéricas en rangos comparables. Si una columna va de 0 a 1 y otra de 0 a 10 millones, algunos algoritmos le darán más peso a la segunda solo por su tamaño.
Pipeline
Qué es: una cadena de pasos (limpieza, encoding, escalado, modelo) que se ejecutan siempre en el mismo orden.
Por qué importa: hace tu trabajo reproducible y ayuda a evitar data leakage, porque cada transformación se aprende solo con los datos de entrenamiento. En scikit-learn se construyen con Pipeline.
Hiperparámetros
Qué es: configuraciones del modelo que tú eliges antes de entrenar, no que el modelo aprende. Por ejemplo, la profundidad máxima de un árbol.
Por qué importa: cambiarlos puede llevar a un modelo de underfitting a overfitting. Se ajustan usando validación cruzada, por ejemplo con búsqueda en malla (grid search).
Parte 6. Más allá de la precisión
Muchos usan estas dos palabras como sinónimos, pero no son lo mismo, y confundirlas lleva a malas decisiones. La diferencia está en de dónde sale el entendimiento: del modelo mismo o de una herramienta externa que intenta describirlo.
Interpretabilidad
Qué es: la propiedad de un modelo cuyo funcionamiento interno una persona puede entender directamente, sin herramientas adicionales. Mirando el modelo ves cómo decide.
Ejemplo: en una regresión logística cada variable tiene un coeficiente. Si el coeficiente de “días de mora” es positivo y grande, sabes que más días de mora aumentan el riesgo, y sabes cuánto. Un árbol de decisión pequeño también es interpretable: puedes seguir las preguntas sí/no de principio a fin.
Por qué importa: la explicación es el modelo. No hay una capa intermedia que pueda equivocarse.
Explicabilidad
Qué es: la capacidad de dar una explicación sobre las decisiones de un modelo que, por sí mismo, no se entiende (una “caja negra” como un Random Forest, XGBoost o una red neuronal). La explicación la produce otra herramienta, después de entrenar el modelo (por eso se le llama explicación post-hoc).
Por qué importa: permite usar modelos más complejos y poderosos sin renunciar del todo a entenderlos. Pero hay que tener claro que la explicación es una aproximación del comportamiento del modelo, no el modelo.
Interpretabilidad vs. explicabilidad: por qué no son lo mismo
Interpretabilidad
Explicabilidad
De dónde sale el entendimiento
Del propio modelo
De una herramienta externa, después de entrenar
Modelos típicos
Regresión lineal y logística, árboles pequeños, reglas
Random Forest, gradient boosting, redes neuronales
Herramientas
Coeficientes, reglas del árbol
SHAP, LIME, importancia por permutación, dependencia parcial
Qué tan fiel es
Exacta: describe lo que el modelo realmente hace
Aproximada: puede no reflejar del todo al modelo
Pregunta que responde
“¿Cómo funciona el modelo?”
“¿Qué influyó en este resultado?”
Hay además dos alcances que aplican a ambas:
Global: cómo se comporta el modelo en general (qué variables importan más en todos los casos).
Local: por qué tomó una decisión concreta (por qué a este cliente se le negó el crédito).
AdvertenciaUna explicación puede ser convincente y estar equivocada
Una explicación post-hoc puede verse muy razonable y aun así no reflejar lo que el modelo hace de verdad. Por eso la investigadora Cynthia Rudin propone, en un artículo muy citado, que en decisiones de alto impacto se usen modelos interpretables en lugar de explicar cajas negras. Si un modelo simple e interpretable logra un rendimiento parecido al de uno complejo, casi siempre es la mejor opción.
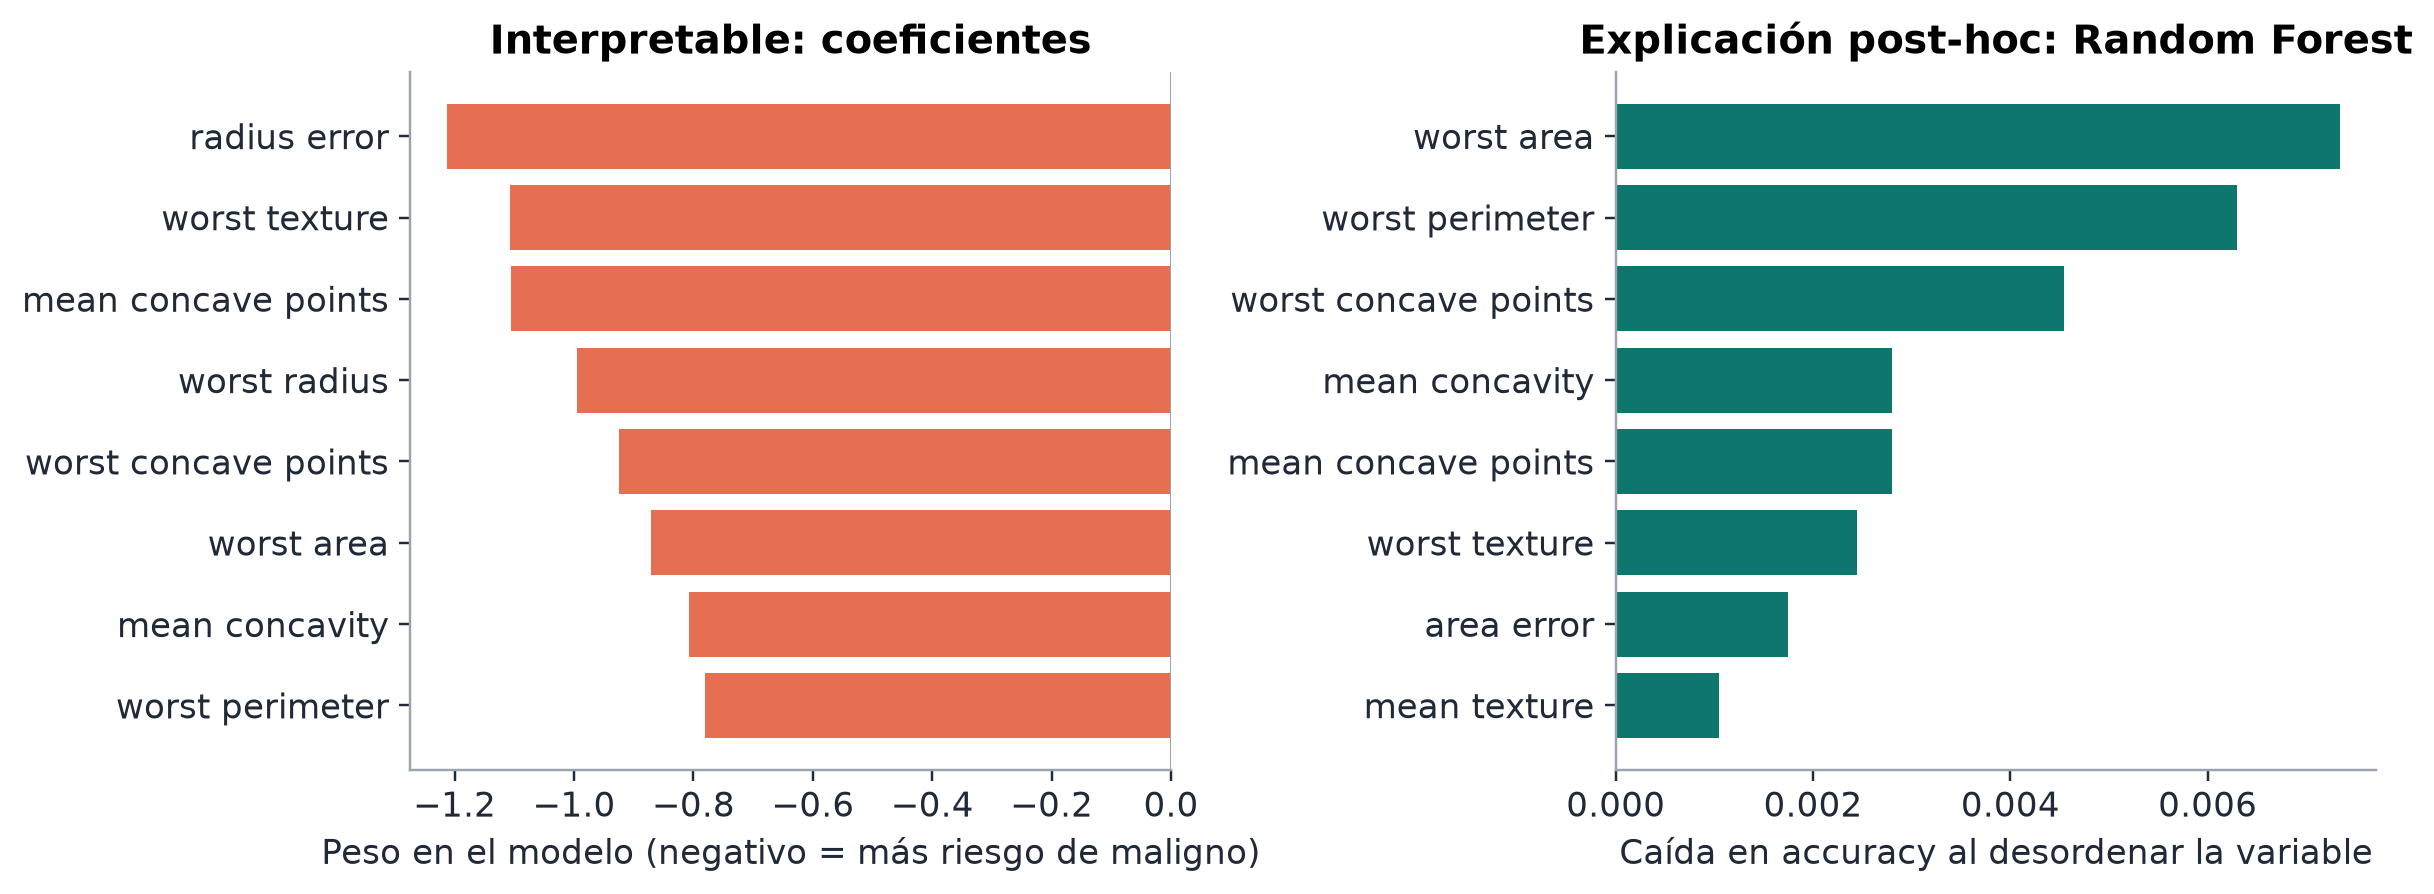
Veámoslo con los mismos datos del ejemplo final. A la izquierda, un modelo interpretable: los coeficientes son el modelo. A la derecha, una explicación de un Random Forest calculada desde afuera, midiendo cuánto empeora el modelo cuando se desordena cada variable.
Ver el código del gráfico
from sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.inspection import permutation_importanceimport pandas as pdcancer = load_breast_cancer(as_frame=True)Xa, Xb, ya, yb = train_test_split(cancer.data, cancer.target, test_size=0.25, stratify=cancer.target, random_state=0)# Interpretable: regresión logística sobre datos escaladoslogit = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)).fit(Xa, ya)coefs = pd.Series(logit[-1].coef_[0], index=Xa.columns)coefs = coefs.reindex(coefs.abs().sort_values().index)[-8:]# Caja negra + explicación post-hoc: Random Forest + importancia por permutaciónbosque = RandomForestClassifier(n_estimators=300, random_state=0).fit(Xa, ya)perm = permutation_importance(bosque, Xb, yb, n_repeats=20, random_state=0)imp = pd.Series(perm.importances_mean, index=Xa.columns).sort_values()[-8:]fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))axes[0].barh(coefs.index, coefs.values, color=[CORAL if v <0else TEAL for v in coefs.values])axes[0].axvline(0, color=GRAY, lw=1)axes[0].set(title="Interpretable: coeficientes", xlabel="Peso en el modelo (negativo = más riesgo de maligno)")axes[1].barh(imp.index, imp.values, color=TEAL)axes[1].set(title="Explicación post-hoc: Random Forest", xlabel="Caída en accuracy al desordenar la variable")plt.tight_layout()plt.show()
Izquierda: interpretabilidad (los coeficientes del modelo). Derecha: explicabilidad (importancia por permutación calculada después de entrenar una caja negra).
Fíjate en que los dos modelos no destacan exactamente las mismas variables. No es un error: son preguntas distintas respondidas con herramientas distintas. Los coeficientes te dicen cómo decide la regresión logística. La importancia por permutación te dice de qué variables depende el Random Forest para acertar, pero no cómo las combina por dentro.
Por qué todo esto importa: si un modelo niega un crédito, la persona y el regulador merecen saber por qué. Y no basta con que exista una explicación: hay que saber si viene del modelo mismo o si es una aproximación, y evaluar qué tan confiable es. Si quieres profundizar, el libro gratuito Interpretable Machine Learning de Christoph Molnar es la referencia más completa.
Sesgo algorítmico
Qué es: cuando un modelo trata de forma injusta a ciertos grupos porque aprendió patrones injustos que ya estaban en los datos históricos.
Por qué importa: un modelo no es neutral por ser matemático. Hereda lo que hay en sus datos.
Data drift (cambio en los datos)
Qué es: cuando los datos del mundo real cambian con el tiempo y dejan de parecerse a los datos con los que entrenaste.
Ejemplo: un modelo de crédito entrenado antes de la pandemia que empieza a fallar después de ella, porque el comportamiento de pago cambió.
Por qué importa: un modelo no se entrena una vez y ya. Hay que monitorearlo.
Todo junto en Python
Este ejemplo usa casi todos los conceptos anteriores con un dataset público que viene incluido en scikit-learn: datos de tumores de mama, donde el objetivo es clasificar si son malignos o benignos.
from sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split, cross_val_scorefrom sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import classification_report, roc_auc_score# 1. Dataset: features (X) y target (y)datos = load_breast_cancer(as_frame=True)X, y = datos.data, datos.targetprint(f"Observaciones: {X.shape[0]} | Variables: {X.shape[1]}")# 2. Separar train y test (el test no se toca hasta el final)X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, stratify=y, random_state=42)# 3. Pipeline: escalado + modelo de clasificaciónmodelo = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))# 4. Validación cruzada sobre train: ¿el rendimiento es estable?scores = cross_val_score(modelo, X_train, y_train, cv=5, scoring="roc_auc")print(f"ROC-AUC en validación cruzada: {scores.mean():.3f} ± {scores.std():.3f}")# 5. Entrenamiento final y evaluación con datos nunca vistosmodelo.fit(X_train, y_train)predicciones = modelo.predict(X_test)probabilidades = modelo.predict_proba(X_test)[:, 1]print(f"ROC-AUC en test: {roc_auc_score(y_test, probabilidades):.3f}")print(classification_report(y_test, predicciones, target_names=datos.target_names))
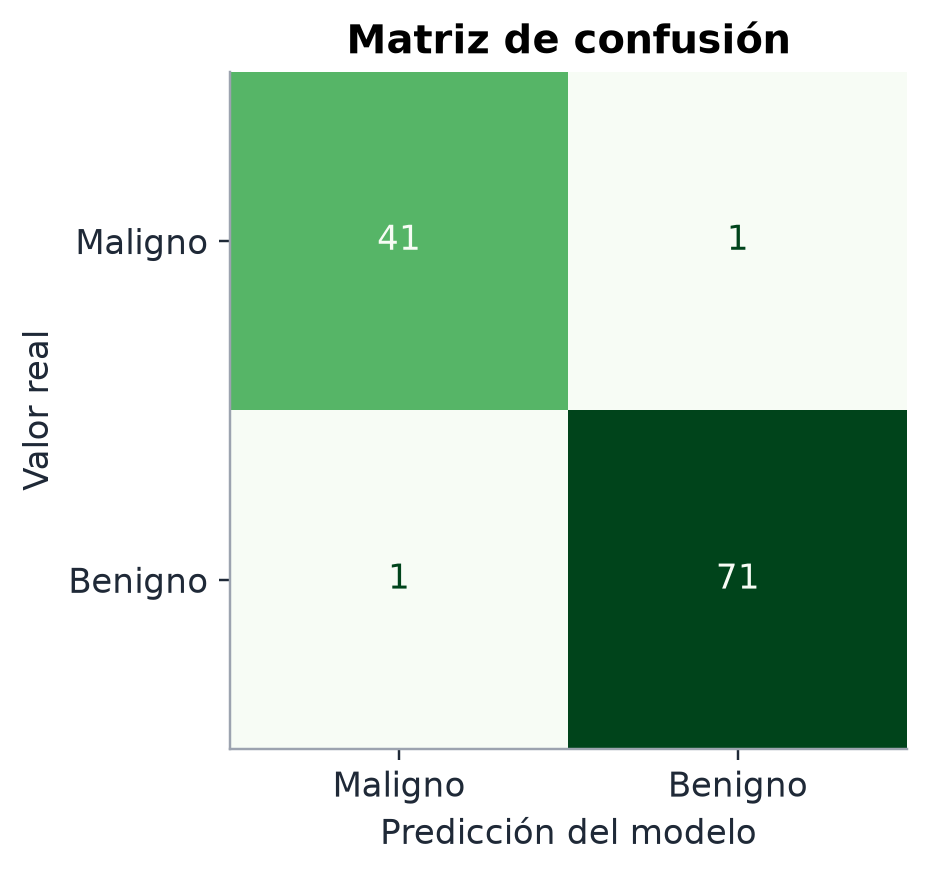
Y la matriz de confusión, para ver exactamente en qué se equivocó el modelo:
from sklearn.metrics import ConfusionMatrixDisplayfig, ax = plt.subplots(figsize=(4.5, 4))ConfusionMatrixDisplay.from_predictions( y_test, predicciones, display_labels=["Maligno", "Benigno"], cmap="Greens", colorbar=False, ax=ax,)ax.set(xlabel="Predicción del modelo", ylabel="Valor real", title="Matriz de confusión")plt.show()
Matriz de confusión del modelo sobre el conjunto de prueba.
Lo que acabas de ver, en palabras: cargamos un dataset, separamos features y target, dividimos en train y test, armamos un pipeline con escalado y un modelo de clasificación, revisamos la estabilidad con validación cruzada y al final medimos con métricas sobre datos que el modelo nunca vio.
Recursos para seguir aprendiendo
Si quieres profundizar, estas son las fuentes oficiales y gratuitas que más uso:
Cursos cortos y gratuitos con datasets reales para practicar
Preguntas frecuentes
¿Necesito saber mucha matemática para empezar en Machine Learning? No para empezar. Con estadística básica y Python puedes avanzar bastante. La matemática se vuelve importante cuando quieres entender por qué los modelos se comportan como lo hacen, y la puedes ir aprendiendo en el camino.
¿Qué lenguaje debo aprender primero para análisis de datos y Machine Learning? Python. Tiene las librerías más usadas (pandas, scikit-learn, PyTorch) y la comunidad más grande. SQL es el segundo idioma que te recomiendo.
¿Cuál es la diferencia entre un analista de datos y un ingeniero de Machine Learning? El analista responde preguntas con datos y comunica hallazgos. El ingeniero de Machine Learning construye, evalúa y pone en producción modelos que hacen predicciones de forma automática. Comparten muchas bases.
¿Qué es el overfitting en Machine Learning? Es cuando un modelo memoriza los datos de entrenamiento, incluido el ruido, y por eso funciona muy bien con ellos pero mal con datos nuevos. Lo explico con un gráfico en la sección de overfitting y underfitting.
¿Cuál es la diferencia entre interpretabilidad y explicabilidad? La interpretabilidad es cuando el propio modelo se puede entender directamente, como los coeficientes de una regresión logística. La explicabilidad es cuando se usa una herramienta externa, como SHAP o LIME, para aproximar por qué un modelo complejo tomó sus decisiones. Lo explico en detalle en la sección de interpretabilidad vs. explicabilidad.
¿Por dónde empiezo? Por el análisis exploratorio. Aprender a mirar un dataset con criterio es la habilidad que más vas a usar, sin importar el rol.
Lo que viene
Cada uno de estos conceptos merece su propio post, con datos reales y código paso a paso. El siguiente será sobre análisis exploratorio de datos: cómo hacer el primer contacto con un dataset sin perderte.
Si algún término de esta guía te quedó confuso o falta alguno que te gustaría ver, escríbeme. Este glosario va a ir creciendo.